Éliminez la friction opérationnelle avec Inférence IA sous 10 ms
Intelligence instantanée pour le l'entreprise souveraine.
Dans le paysage à enjeux élevés de 2026, la latence est le tueur silencieux de la productivité. Les architectures IA traditionnelles sont limitées par des recherches lentes dans des bases de données externes. Okiff IA brise la barrière de vitesse en préchargeant votre intelligence dans la mémoire immédiate du GPU.
Notre architecture de génération augmentée par cache (CAG) offre un raisonnement quasi instantané. Nous contournons les délais de récupération basés sur le cloud, permettant une prise de décision en temps réel pour les industries réglementées. Sécurisez vos données, accélérez vos flux de travail et possédez votre intelligence sans compromis.
Au-delà de la génération augmentée par récupération traditionnelle : La vitesse des systèmes augmentés par contexte.
De secondes à millisecondes : La nouvelle norme pour l'intelligence industrielle.
La génération augmentée par récupération traditionnelle (RAG) souffre souvent de silos de "connaissances tribales" et de récupération de données fragmentées. Ce processus introduit une friction opérationnelle significative. Le modèle doit rechercher à travers des millions de morceaux de documents pour chaque requête.
Notre solution utilise la Génération Augmentée par Cache (CAG). En préchargeant votre base de connaissances d'entreprise directement dans le Cache KV du GPU, nous éliminons le besoin de récupération de données en temps réel. Cela se traduit par des vitesses de génération jusqu'à 40 fois plus rapides que les modèles de récupération standard.
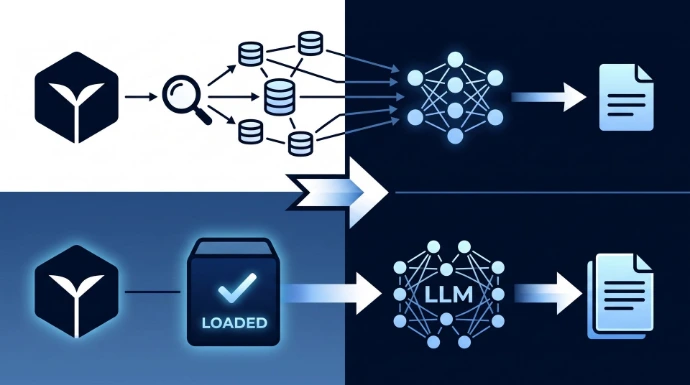
Comparaison de Stratégie Technique : RAG vs. CAG
Caractéristique | Génération Augmentée par Récupération (RAG) | Génération Augmentée par Cache (CAG) |
|---|---|---|
Latence de Réponse | 200ms – 2,000ms+ (Variable) | Moins de 10ms (Déterministe) |
État de Connaissance | Réactif (Recherché à la volée) | Proactif (Préchargé en mémoire) |
Complexité du Système | Élevée (DBs vectoriels, classificateurs, récupérateurs) | Faible (Gestion directe du Cache KV) |
Intégrité Contextuelle | Risque élevé de "Perdu au Milieu" | Compréhension holistique des documents |
Coût de Calcul | Frais de recherche élevés par requête | Construction de cache unique amortie |
Conformité Absolue dans un Paysage Réglementé
Une vitesse inégalée ne devrait jamais se faire au détriment de la sécurité des données
Les entreprises opérant en 2026 font face à des délais compressés pour la conformité réglementaire. La Loi 25 du Québec et la Loi sur l'IA de l'UE exigent une résidence stricte des données et une transparence des décisions automatisées. L'IA traditionnelle basée sur le cloud expose souvent les organisations à la Loi CLOUD des États-Unis.
Okiff AI construit un "Mur de Données" autour de votre intelligence. En déployant via Hardware-as-a-Service (HaaS) ou des nœuds locaux, vos données sensibles restent dans votre juridiction. Notre architecture fournit une traçabilité transparente, garantissant que chaque réponse de l'IA est prête pour un audit et défendable.
Délais réglementaires et impact de la conformité
Réglementation | Date limite opérationnelle | Exigence principale | Solution Okiff |
|---|---|---|---|
Loi 25 du Québec | Appliquée 2024-2026 | Transparence explicite de l'IA et PIAs | Journaux locaux et PIAs intégrés |
Loi sur l'IA de l'UE | 2 août 2026 | Journalisation et supervision des systèmes à haut risque | Contrôle de version OKF traçable |
Projet de loi C-36 du Canada | Proposé 2026 | Consentement significatif pour la logique de l'IA | Trails d'audit de l'IA en langage clair |
RGPD | En vigueur | Évaluations des transferts transfrontaliers | Hébergement souverain localisé |
Notre pile souveraine unifie l'identité, les données et la politique au niveau du noyau. Cela empêche les fuites de données tout en maintenant le débit élevé requis pour l'infrastructure sociale et la défense. La conformité n'est plus un ajout ; c'est la fondation de notre vitesse.
Connaissance en tant que Code: La Révolution OKF
Cessez de rechercher. Commencez à interconnecter votre intelligence.
Le principal goulot d'étranglement pour les agents IA est le texte fragmenté et non structuré. Le Format Ouvert de Connaissance (OKF) de Google Cloud remet en question l'hypothèse selon laquelle la connaissance doit être redérivée à chaque requête. OKF emballe votre contenu organisé sous forme de fichiers Markdown liés avec des métadonnées YAML.
En adoptant OKF, votre organisation transforme la documentation statique en un graphe de connaissances navigable. Ce modèle "LLM-Wiki" permet aux agents de naviguer dans vos données de manière délibérée. Il garantit que votre propriété intellectuelle reste portable, contrôlée par version, et complètement indépendante de tout fournisseur d'IA.
Les Trois Piliers de l'Interopérabilité OKF

Juste Markdown
Le contenu est lisible par l'homme, soutenu par Git, et indexable par n'importe quel outil sans SDK propriétaires.

Juste des Fichiers
Expédier des connaissances est aussi simple que de cloner un dépôt Git ou de monter un système de fichiers.

Juste YAML
Les métadonnées structurées garantissent que vos concepts sont instantanément interrogeables et filtrables par les agents IA.
Ce format réduit les informations dupliquées et garantit que les agents n'ont jamais à deviner. En structurant le contenu autour de concepts clairs, nous fournissons la "Connaissance Dorée" dont les agents ont besoin pour leurs opérations quotidiennes. La gestion des connaissances reçoit enfin la même discipline que le développement logiciel.
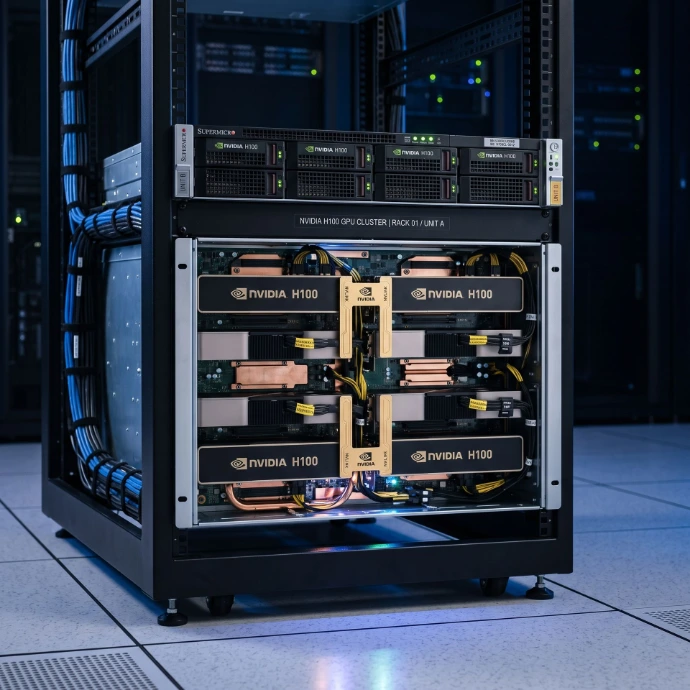
Matériel de qualité industrielle pour Vitesse critique pour la mission
Les logiciels d'élite nécessitent les moteurs d'inférence les plus puissants au monde.
Une latence inférieure à 10 ms n'est réalisable que lorsque les optimisations de couche logicielle rencontrent une infrastructure de mémoire à large bande (HBM). Nous livrons notre pile d'IA souveraine via des nœuds préconfigurés qui s'initialisent automatiquement. Cela permet un accès quasi instantané à de grandes fenêtres contextuelles complexes.
Notre modèle de matériel en tant que service (HaaS) élimine les barrières élevées de CapEx à l'adoption de l'IA. Que vous ayez besoin de nœuds Edge sur site pour la guidance robotique ou de serveurs centraux pour le raisonnement d'entreprise, nous fournissons le silicium dédié nécessaire à l'accélération des mécanismes d'attention.
Objectifs de latence par cas d'utilisation d'entreprise
Cas d'utilisation | Objectif de latence | Pourquoi les millisecondes comptent |
|---|---|---|
Détection de fraude | < 10 ms | La transaction doit être notée avant l'autorisation. |
Rejets à haute vitesse | < 15 ms | Les décisions à la vitesse de la ligne empêchent le gaspillage de production. |
Guidage robotique | < 20 ms | Des boucles de vision précises nécessitent un retour d'information instantané. |
Agents IA vocaux | < 200 ms | Tolérance humaine pour les pauses conversationnelles. |
Tarification dynamique | < 100 ms | Le rendu de page en temps réel bloque sur les prix. |
Nous priorisons l'efficacité énergétique grâce à des modèles spécifiques aux tâches. Ce "Cycle circadien de calcul" redirige la puissance de calcul vers la formation de l'IA après les heures de bureau, garantissant que vos taux d'utilisation dépassent 85 %. Vous obtenez des performances maximales avec une empreinte environnementale réduite.
Intelligence Inclusive: Accessible à Tous
Établir la norme pour l'utilisabilité web et l'accessibilité cognitive.
En 2026, l'accessibilité n'est pas juste une case à cocher ; c'est une exigence légale et éthique. Nos pages d'atterrissage sont conçues pour répondre aux normes WCAG 2.2 Niveau AA. Nous veillons à ce que chaque utilisateur, quelle que soit sa capacité, puisse naviguer dans notre écosystème IA à haute vitesse.
Nous avons éliminé les cibles de tapotement minuscules et les états de focus cachés. Chaque élément interactif—des boutons aux champs de formulaire—est conçu avec une taille minimale de 24x24 pixels. Cela garantit l'utilisabilité sur les appareils mobiles et pour les utilisateurs ayant un contrôle moteur limité.
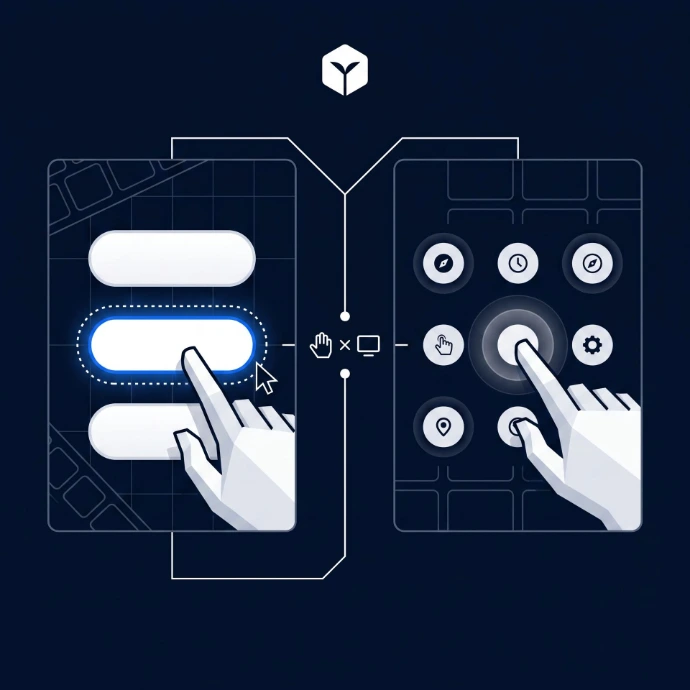
Fonctionnalités Clés d'Accessibilité pour 2026
Visibilité du Focus
Nous utilisons des indicateurs de focus à contraste élevé afin que les utilisateurs de clavier ne perdent jamais leur place.
Réduction de la Charge Cognitive
Nos formulaires utilisent le remplissage automatique et des emplacements d'aide cohérents pour réduire la friction mentale.
Structure Sémantique
Une hiérarchie appropriée des balises H permet aux lecteurs d'écran d'interpréter avec précision l'"Arbre d'Accessibilité" de la page.
Authentification Accessible
Nous proposons des alternatives aux énigmes complexes ou aux tests de mémoire lors des processus de connexion.
En respectant les principes "POUR"—Perceptible, Opérable, Compréhensible et Robuste—nous garantissons que notre contenu résiste à l'examen des régulateurs et des utilisateurs. Votre site web devrait être un pont vers votre technologie, pas une barrière.
FAQs (Les gens aussi Demande)
Comment CAG atteint-il une latence inférieure à 10 ms par rapport à RAG ?
Le RAG traditionnel récupère des données à partir de bases de données externes pour chaque requête, ajoutant un délai de 200 ms à 2 000 ms. CAG précharge votre base de connaissances dans le cache KV du GPU une fois, permettant au modèle de "se souvenir" du contexte instantanément lors de l'inférence.
Qu'est-ce que le Format de Connaissance Ouverte (OKF) et pourquoi est-il neutre par rapport aux fournisseurs ?
L'OKF est une spécification basée sur un répertoire utilisant Markdown et YAML. C'est un "format, pas un service," ce qui signifie que vos connaissances ne sont pas verrouillées dans un cloud ou un SDK propriétaire. Elles peuvent être déplacées à travers n'importe quel cadre d'IA sans traduction.
Comment Okiff AI assure-t-il la conformité avec la Loi 25 et la Loi sur l'IA de l'UE ?
Nous utilisons une architecture souveraine "locale d'abord". En exécutant l'IA sur site ou sur des nœuds de cloud souverains, nous gardons les données hors de la juridiction américaine (risque de la Loi CLOUD) et fournissons la journalisation transparente requise par les lois modernes sur la vie privée.
Quel est le principal avantage opérationnel d'utiliser un "Cycle Circadien de Calcul" pour le calcul ?
Il maximise l'efficacité énergétique en redirigeant la puissance de calcul des inférences vers les tâches de formation de l'IA pendant les heures creuses, garantissant des taux d'utilisation de l'infrastructure supérieurs à 85 %.
En quoi l'approche "Data Wall" diffère-t-elle de la sécurité périmétrique traditionnelle ?
Contrairement aux pare-feu traditionnels qui protègent le bord du réseau, le Data Wall intègre la sécurité directement dans la pile d'IA via HaaS ou des nœuds locaux, garantissant la résidence des données au sein de juridictions spécifiques et empêchant l'accès externe non autorisé.
Pourquoi le passage à l'OKF améliore-t-il la collaboration entre les développeurs et les agents d'IA ?
OKF traite la connaissance comme un code lisible par l'homme et contrôlé par version, permettant aux développeurs de maintenir la documentation en utilisant des flux de travail Git standard tout en fournissant aux agents IA un modèle de navigation prévisible et structuré pour des résultats de requête plus rapides.
Le CAG peut-il être utilisé pour de grands ensembles de données qui changent fréquemment ?
Le CAG est idéal pour la "Connaissance Dorée"—des ensembles de données stables comme des politiques, des manuels et des documents techniques. Pour des bibliothèques massives et en évolution rapide, nous recommandons une approche hybride en niveaux : CAG pour l'identité de base et RAG pour la recherche à long terme.